... ↑
elgru в посте Metapractice (оригинал в ЖЖ)
5 комментариев
сначала старые сначала новые
Вот есть такая "собака для битья" со стороны науки в НЛП — ключи глазного доступа. Можно статистически показать, анализируя записи с экрана (нивелируя воздействие исследователя), что есть связь между категориями слов, которые говорят люди, и боковыми движениями глаз:
— на уровне отдельно взятого индивида
— на уровне разных культурных групп
— на уровне человечества в целом
Рандомизированные исследования с онтологизированием разнообразия субъектов как раз будет безупречным "количественным" доказательством такой связи. А без рандомизации как?
— на уровне отдельно взятого индивида
— на уровне разных культурных групп
— на уровне человечества в целом
Рандомизированные исследования с онтологизированием разнообразия субъектов как раз будет безупречным "количественным" доказательством такой связи. А без рандомизации как?
Раз вмешательство с уровня модели, тогда и рандомизация с этого же уровня.
Вмешательство может идти с уровня знания оператором феномена. С той или иной эффективностью.
Но поскольку, применение не причёсанного феномена для вмешательства нетипично, то рандомизация прописана на уровне паттерна.
А вот паррерны для вмешательства применяются вовсю. Например, мы давеча с вами обсуждали паттерн лево -правой экспресии, который вполне работает, но в настоящее время не проработан до модели.
Рандомизация - формализованное, по заранее прописанным правилам, случайное распределение субьектов/предметов наблюдения/вмешательства на группы сравнения.
Цель рандомизации - сделать группы сходными по признакам, которые могут повлиять на искомый результат.
Опишите, на каком этапе и как будет проводиться рандомизация при исследовании КГД с онтологизированием разнообразия субьектов.
Т.е. дизайн конкретного исследования в студию!
Цель рандомизации - сделать группы сходными по признакам, которые могут повлиять на искомый результат.
Опишите, на каком этапе и как будет проводиться рандомизация при исследовании КГД с онтологизированием разнообразия субьектов.
Т.е. дизайн конкретного исследования в студию!
Прежде, чем формулировать дизайн исследования, надо отметить, что существует минимум ВОСЕМЬ вариантов КГД — восемь оснований для группировки субъектов:
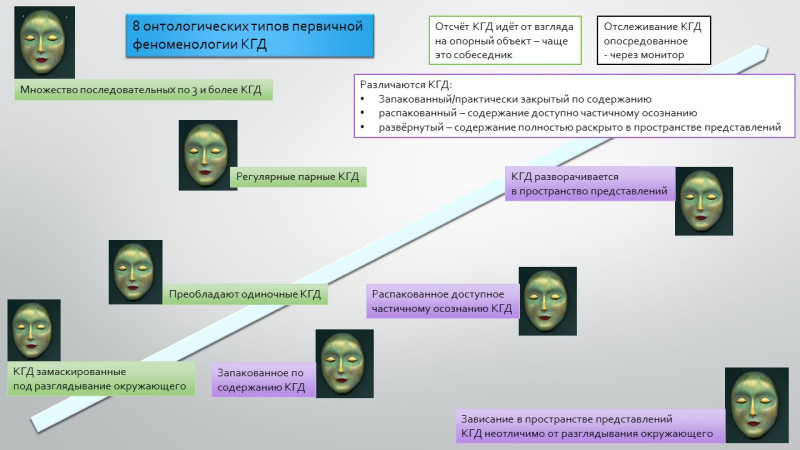
Если общую выборку делать без учёта этого разнообразия вариантов проявления феномена, получится пресловутая "средняя температура по больнице" — исходный феномен будет нивелирован. Это позволяет делать плохому рандомизатору, прикрываясь умными вычислениями, пустые заявления об отсутствии КГД и т.п.
Если общую выборку делать без учёта этого разнообразия вариантов проявления феномена, получится пресловутая "средняя температура по больнице" — исходный феномен будет нивелирован. Это позволяет делать плохому рандомизатору, прикрываясь умными вычислениями, пустые заявления об отсутствии КГД и т.п.
Просто, с каждым онтологическим типом выявление КГД следует делать особенным путём/ подходом.