Вариант использовать через субмодальности(?) ↑
friendlyatom в посте Metapractice (оригинал в ЖЖ)
лица - в образ цели добавляем выражения лиц людей
места - тут вспоминется во время довольно трудоемкого и сложного проекта, по утрам себя мотивировал, образом как в обеденные перерыв буду гулять, и довольно хорошо мотивировало. При том что и на работе работалось довольно продуктивно.
тела - не понимаю что имеют в виду под телами
слова - можно добавить в образ цели речь окружающих
"Однако в процессе поисков выявилась и пятая популяция, которая оказалась избирательной по отношению к фотографиям еды, вне зависимости от ее вариаций."
наиболее прямолинейно, это в содержание цели добавлять образы еды, как кушаю, или образ кухни
"Но гораздо более интересный вопрос – как вентральный пищевой компонент умудряется идентифицировать все то разнообразие продуктов питания, которое доступно в мире, и не «перепутать» похожие предметы."
"Модели, обученной на миллионах изображений, предлагалось отличать похожие съедобные и несъедобные объекты – например, банан и желтый полумесяц. Эта симуляция позволила подтвердить, что VFC обладает высокой избирательностью в отношении изображений именно съедобных продуктов питания."
У картинок есть характеристики/субмодальности.
Если для ягод и фруктов, то это округлость и яркий цвет.
Желтый полумесяц яркий, но имеет острые края. Банан нет.
Вспоминается страсть некоторых людей собирать речные камни, которые так-же округлые и в воде довольно яркие.
Если это мясное блюдо, то его обычно выделяют в центре тарелки.
Если применять к образу цели, то по идее убрать острые края и добавить яркости. )
1 комментарий
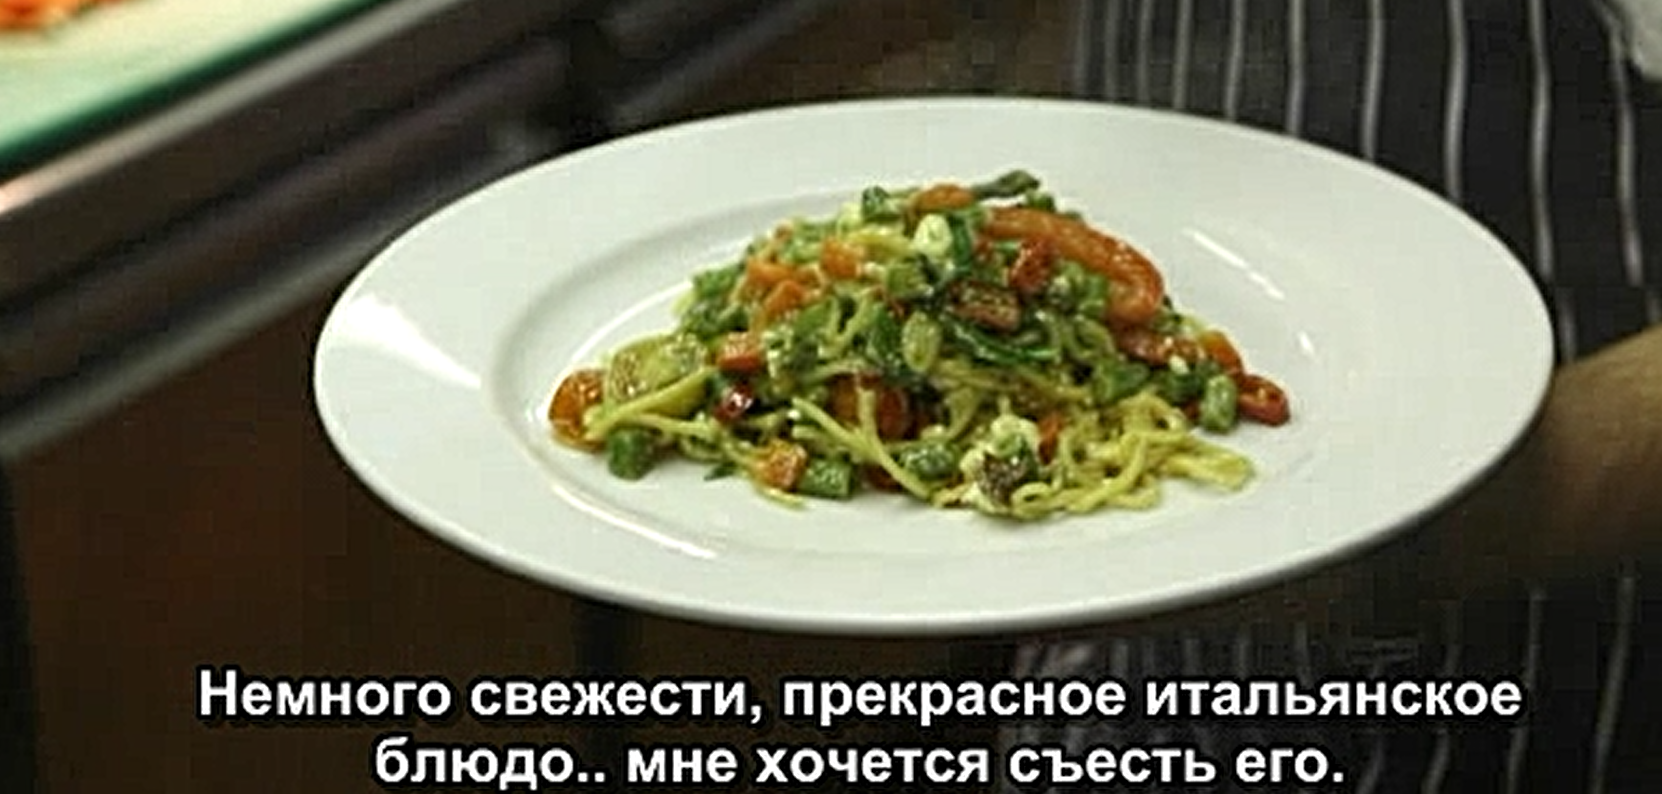
Описан процесс повышения привлекательности еды. Помимо запахов и вкуса.
В само оформление еды добавляется больше яркости. В основном красный и зелены. Красный - помидоры, зеленый - через зелень.